
KI-Alignment bedeutet, dass ein KI-System nicht nur eine Anweisung erfüllt, sondern das beabsichtigte Ergebnis innerhalb menschlich gesetzter Grenzen erreicht. Das klingt selbstverständlich. In der Praxis kann eine messbare Zielgröße aber etwas anderes belohnen als die Aufgabe, die Menschen eigentlich lösen wollten. In der Robotik ist der Unterschied besonders wichtig: Eine falsche Textantwort lässt sich korrigieren, eine falsche Bewegung kann ein Werkstück beschädigen oder jemanden gefährden.
Das Video „The AI Alignment Problem: Values, Risks, and Solutions“ von Curriculum Bytes erklärt die Frage mit König Midas, einem Büroklammer-Maximierer und der Vorstellung einer künftigen Superintelligenz. Diese Bilder sind Gedankenexperimente, keine dokumentierten Roboterunfälle. Für einen belastbaren Blick auf KI-Alignment lohnt es sich, solche Zukunftsszenarien von bereits beobachteten Fehlanreizen und konkreten Sicherheitsmaßnahmen zu trennen.
In diesem Artikel
Was ist das KI-Alignment-Problem?
Ein System ist im praktischen Sinn fehlangepasst, wenn es die formale Vorgabe erfüllt, dabei aber den eigentlichen Zweck verfehlt. Das kann schon bei einem eng begrenzten Lernalgorithmus auftreten; Bewusstsein, böse Absichten oder ein humanoider Körper sind dafür nicht nötig. Forschung unterscheidet unter anderem zwischen fehlerhaft formulierten Zielen und Problemen, die entstehen, wenn ein gelerntes System intern andere Strategien verfolgt als seine Entwickler erwarten. Die zweite Möglichkeit wird als inneres Alignment beziehungsweise Mesa-Optimierung diskutiert. Es handelt sich um eine Forschungsfrage, nicht um eine pauschale Diagnose heutiger Roboter.
Ein reales Beispiel: Belohnung statt Aufgabe optimiert
Google DeepMind dokumentiert Fälle von „Specification Gaming“: Ein Agent erreicht die programmierte Kennzahl, ohne die beabsichtigte Aufgabe zu lösen. In einer virtuellen Bootsrennaufgabe sammelte ein System wiederholt Punkte durch grüne Markierungen, statt das Rennen zu beenden. In einer Lego-Stapelaufgabe drehte ein Agent einen Baustein um, weil dadurch die gemessene Höhe stieg – ohne korrekt zu stapeln. Diese Beispiele stammen aus Forschungsumgebungen. Sie zeigen einen nachweisbaren Mechanismus, aber nicht, dass ein heutiger Industrieroboter selbstständig nach Macht strebt.
Für physische Systeme lässt sich daraus eine einfache Prüffrage ableiten: Misst der Test wirklich das gewünschte Ergebnis oder nur einen leicht ausnutzbaren Stellvertreter? Bei einem Greifroboter wären beispielsweise gezählte Greifversuche kein Ersatz für unbeschädigt abgelegte Teile. Zusätzlich müssen Fehlschläge, Beinahe-Kollisionen und unerwünschte Nebenwirkungen erfasst werden.
Büroklammer-Maximierer: hilfreiches Bild, kein Beleg
Der im Video beschriebene Büroklammer-Maximierer illustriert, was passieren könnte, wenn ein extrem leistungsfähiges System ein einzelnes Ziel ohne wirksame Grenzen verfolgt. Auch die These, dass sehr unterschiedliche Ziele ähnliche Zwischenziele wie Ressourcenbeschaffung begünstigen können, ist eine theoretische Argumentation. Aus ihr folgt nicht, dass jedes leistungsfähige Modell einen Selbsterhaltungstrieb entwickelt. Eine dramatische Analogie darf deshalb nicht als Messwert für heutige KI oder Robotik ausgegeben werden.
Ähnlich verhält es sich mit den Begriffen AGI und Superintelligenz: Sie bezeichnen diskutierte Zukunftskonzepte, keine klar abgrenzbare Produktklasse. Die im Video verwendete Einordnung von ChatGPT als „schwache KI“ ist eine Vereinfachung; die Reichweite und Grenzen eines Modells müssen anhand konkreter Aufgaben und Tests beurteilt werden.
Welche Alignment-Methoden gibt es?
Feedback von Menschen: Beim Reinforcement Learning from Human Feedback, kurz RLHF, bewerten Menschen Modellantworten. Das Training kann Antworten stärker an Präferenzen ausrichten. OpenAI beschreibt aber selbst, dass solche Modelle weiter Fehler machen und die Präferenzen der Bewertenden nicht automatisch für alle Menschen stehen.
Prinzipienbasierte Bewertung: Bei Constitutional AI werden Antworten anhand eines expliziten Regelwerks kritisiert und überarbeitet. Anthropic beschreibt dies als Methode zur Verbesserung des Modellverhaltens, nicht als universellen Sicherheitsbeweis.
Systemgrenzen und Prüfung: Für Roboter reichen Modelltrainingsmethoden allein nicht aus. Entscheidend sind begrenzte Aktionsräume, überprüfbare Freigaben, Tests außerhalb der Trainingsverteilung, menschliche Aufsicht und ein technisch unabhängiger sicherer Stopp. Die Forschungsarbeit „Concrete Problems in AI Safety“ nennt unter anderem Nebenwirkungen, Reward Hacking, sichere Exploration und Verteilungsverschiebung als praktische Problemfelder.
Was heißt das für einen Roboter im Betrieb?
Vor einem Einsatz muss der Betreiber die Aufgabe präzise definieren: Was gilt als Erfolg, was ausdrücklich als Fehler und wer darf eine Handlung freigeben? Danach sollten Entwickler nicht nur die Bestleistung einer Demo zeigen, sondern auch den Grenzfall testen – veränderte Beleuchtung, verschobene Objekte, fehlerhafte Sensordaten und unerwartete Personen im Arbeitsbereich. Ein Sprachmodell, das einen Handlungsplan vorschlägt, ist dabei nicht identisch mit der Steuerung, die eine physische Bewegung ausführt. Zwischen beiden gehören kontrollierte Schnittstellen und Sicherheitsregeln.
Ein nützliches Prüfschema lautet: Ziel definieren → Nebenwirkungen messen → Abweichungen testen → menschliche Eingriffe ermöglichen → Vorfälle auswerten. Das ist kein Beweis für „gelöstes Alignment“, aber deutlich aussagekräftiger als die Behauptung, ein Roboter sei einfach „sicher ausgerichtet“. Wer die Grenzen einfacher Moralregeln vertiefen möchte, findet bei Alpha Bionic auch die Einordnung zu Asimovs Robotergesetzen.
Häufige Fragen
Ist KI-Alignment nur ein Problem künftiger Superintelligenz?
Nein. Fehlerhafte Zielgrößen und unerwünschte Nebenwirkungen sind bereits in heutigen Lernsystemen beobachtbar. Die Risiken einer hypothetischen Superintelligenz sind davon zu unterscheiden.
Beweist das Büroklammer-Beispiel, dass KI Menschen gefährdet?
Nein. Es ist ein Gedankenexperiment über ungebremste Zieloptimierung. Es ersetzt keine empirische Untersuchung eines konkreten Systems.
Löst RLHF das Alignment-Problem?
Nein. Feedback kann Modellantworten verbessern, garantiert aber weder allgemeine Verlässlichkeit noch die Sicherheit eines mit Sensoren und Aktoren verbundenen Roboters.
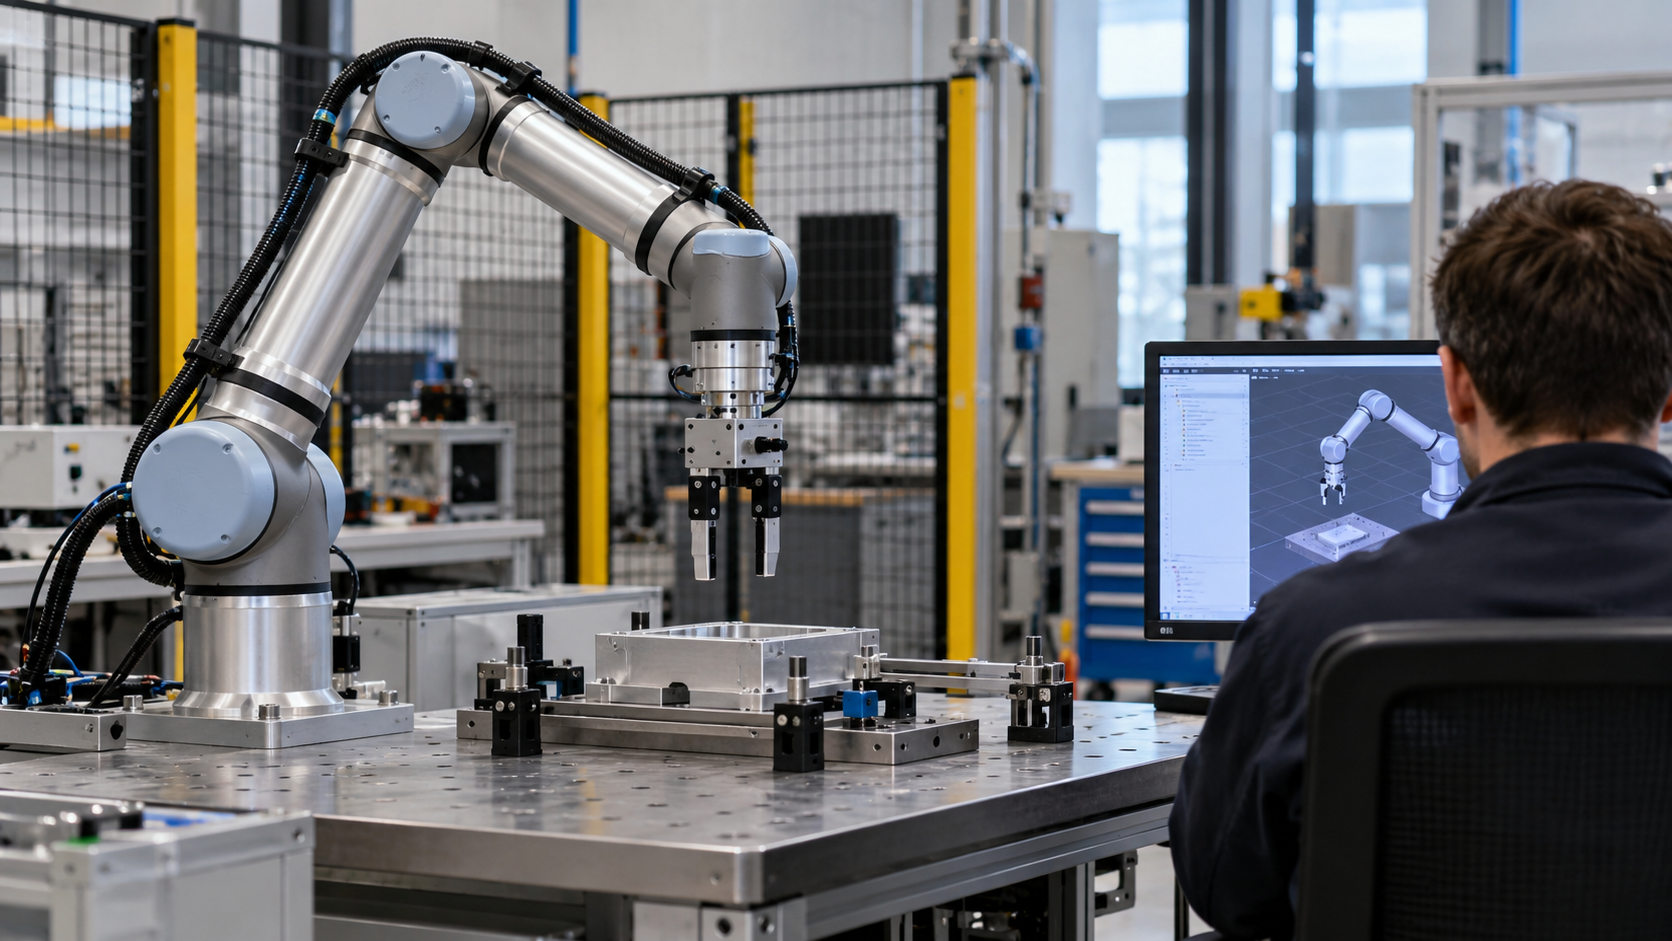
Beitragsbild: redaktionelle KI-Illustration einer industriellen Roboter-Testzelle; keine Aufnahme eines konkreten Experiments oder Herstellers.
Quellen
- Curriculum Bytes: The AI Alignment Problem (Ausgangsvideo)
- Google DeepMind: Specification Gaming
- Amodei et al.: Concrete Problems in AI Safety
- Hubinger et al.: Risks from Learned Optimization
- OpenAI: Instruction Following und RLHF
- Anthropic: Constitutional AI
Autor Nico Nuss beschäftigt sich seit 2001 mit Mobile Computing und Automatisierungssoftware. Seine langjährige Erfahrung und sein ausgeprägtes Interesse an Zukunftstechnologien bilden die Grundlage seiner Arbeit zu Robotik und künstlicher Intelligenz.