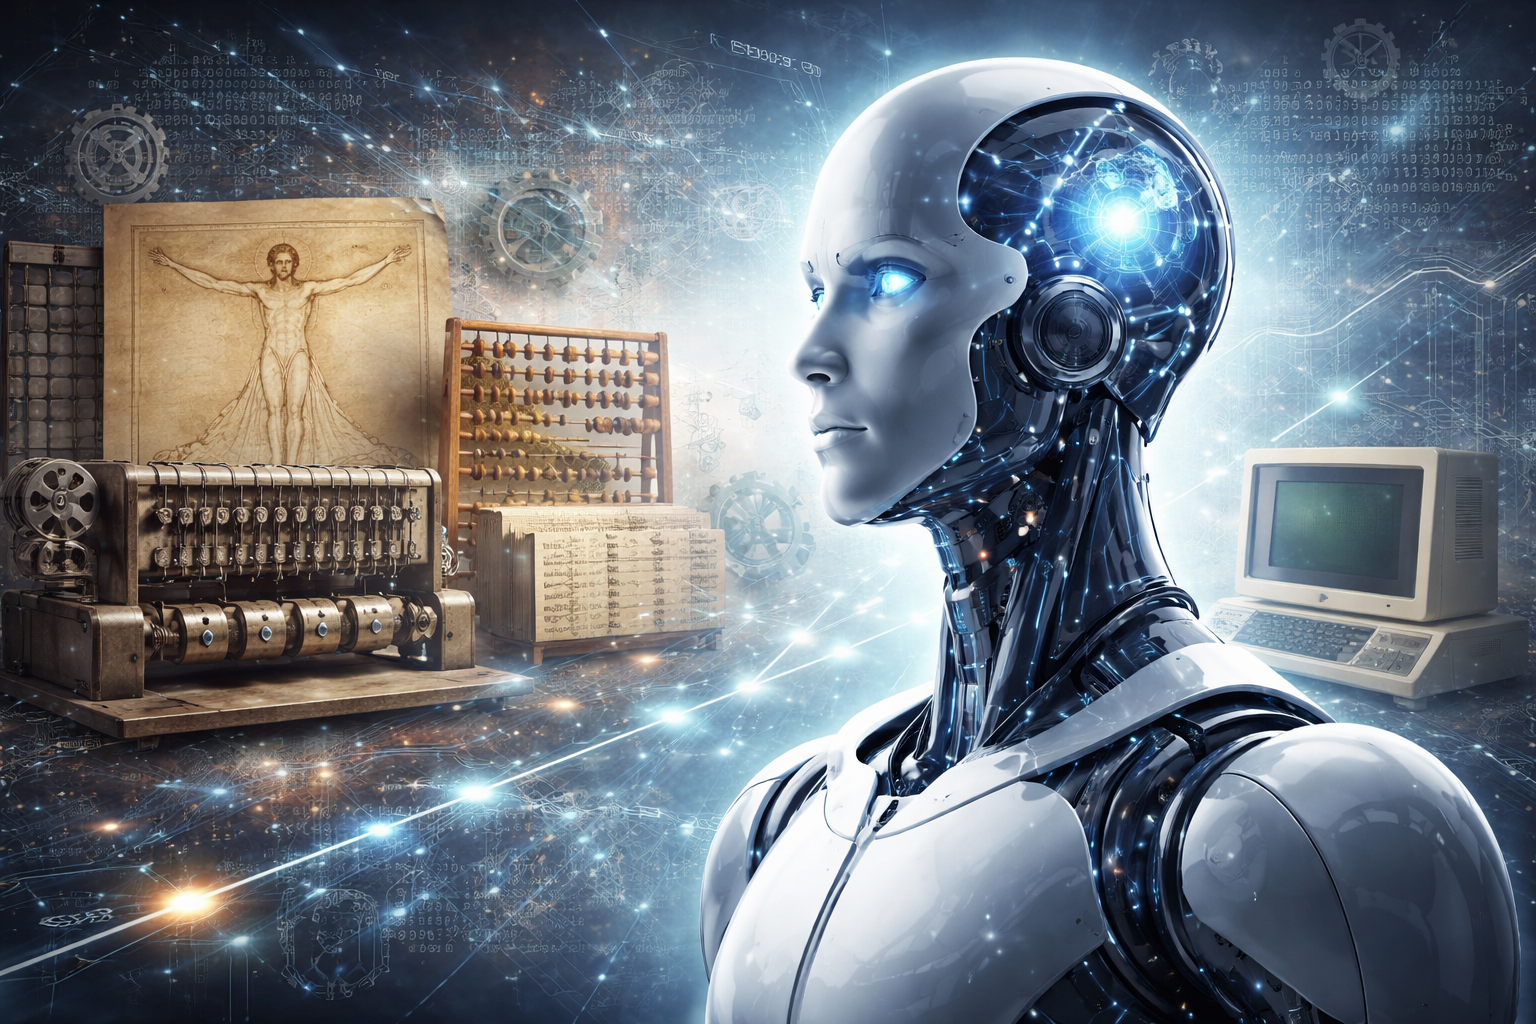
Seit wann gibt es Künstliche Intelligenz? Eine einzige Jahreszahl reicht als Antwort nicht aus. Die theoretischen Grundlagen entstanden bereits in den 1930er- und 1940er-Jahren. Der Begriff „Artificial Intelligence“ tauchte 1955 in einem Forschungsantrag auf. Als eigenständiges wissenschaftliches Fachgebiet gilt KI jedoch erst seit dem Dartmouth-Treffen im Sommer 1956.
Was damals wie eine ziemlich kühne Idee wirkte, steckt heute in Suchmaschinen, Smartphones, Navigationssystemen, industriellen Robotern und generativen Anwendungen wie ChatGPT. Dazwischen lagen mehrere Durchbrüche, überzogene Versprechen, zwei sogenannte KI-Winter und Jahrzehnte mühsamer Forschungsarbeit.
Die direkte Antwort: Künstliche Intelligenz gibt es als wissenschaftliches Forschungsgebiet seit 1956. Der Begriff wurde bereits 1955 von John McCarthy im Antrag für das Dartmouth Summer Research Project on Artificial Intelligence verwendet. Mathematische und technische Vorläufer reichen mindestens bis in die 1930er- und 1940er-Jahre zurück.
In diesem Artikel
Das Wichtigste in Kürze
- 1936: Alan Turing beschreibt ein theoretisches Modell für universell programmierbare Rechenmaschinen.
- 1943: Warren McCulloch und Walter Pitts veröffentlichen ein mathematisches Modell künstlicher Nervenzellen.
- 1955: Im Antrag für das Dartmouth-Forschungsprojekt erscheint der Begriff „Artificial Intelligence“.
- 1956: Das Dartmouth-Treffen gilt als Geburtsstunde der KI als wissenschaftliche Disziplin.
- 1957/1958: Frank Rosenblatt entwickelt und präsentiert das Perzeptron als frühes lernfähiges Modell.
- 1966: ELIZA zeigt, wie ein Computer ein menschlich wirkendes Gespräch simulieren kann.
- 1970er- und 1980er-Jahre: Expertensysteme erleben einen Boom, später folgen die sogenannten KI-Winter.
- 1997: IBMs Deep Blue besiegt Schachweltmeister Garri Kasparow.
- 2012: AlexNet beschleunigt den Durchbruch des Deep Learning in der Bilderkennung.
- 2017: Die Transformer-Architektur schafft die technische Grundlage moderner Sprachmodelle.
- 2022: Mit ChatGPT erreicht generative KI ein Millionenpublikum.
Seit wann gibt es KI wirklich?
Wer nach dem Beginn der KI fragt, kann drei verschiedene Antworten erhalten. Alle drei sind richtig, beziehen sich aber auf unterschiedliche Ebenen:
- Die Idee künstlicher Intelligenz ist Jahrhunderte alt. Philosophen, Mathematiker und Konstrukteure beschäftigten sich lange vor dem Computer mit künstlichen Wesen, Automaten und mechanisiertem Denken.
- Die mathematischen und technischen Grundlagen entstanden vor allem zwischen den 1930er- und 1950er-Jahren.
- Die KI als eigenständiges Forschungsgebiet beginnt nach allgemeiner wissenschaftshistorischer Einordnung im Jahr 1956.
Die oft genannte Jahreszahl 1956 ist deshalb kein beliebig gewähltes Datum. Im Sommer dieses Jahres traf sich am Dartmouth College in den USA eine kleine Gruppe von Forschern, um systematisch zu untersuchen, ob sich Aspekte menschlichen Lernens und Denkens mit Maschinen nachbilden lassen. Das vom Bundesministerium für Bildung und Forschung geförderte Geschichtsprojekt des Deutschen Museums bezeichnet dieses Treffen als Teil des Gründungsnarrativs der KI-Forschung.
Die Frage „Seit wann gibt es KI?“ lässt sich daher am saubersten so beantworten: Als Idee ist KI sehr alt, als technische Forschungsrichtung entwickelte sie sich ab den 1940er-Jahren und als eigenständige wissenschaftliche Disziplin existiert sie seit 1956.
Zeitleiste: Die wichtigsten Meilensteine der KI-Geschichte
| Jahr | Entwicklung | Bedeutung für die KI |
|---|---|---|
| 1936 | Turingmaschine | Alan Turing beschreibt ein theoretisches Modell für algorithmische Berechnungen. |
| 1943 | Künstliches Neuron | McCulloch und Pitts modellieren erstmals eine Nervenzelle mit mathematischen Regeln. |
| 1950 | Turing-Test | Turing schlägt ein Gedankenexperiment zur Bewertung maschineller Kommunikation vor. |
| 1955 | Begriff „Artificial Intelligence“ | Der Begriff erscheint im Antrag für das Dartmouth-Forschungsprojekt. |
| 1956 | Dartmouth-Treffen | Die Veranstaltung gilt als Geburtsstunde der KI als wissenschaftliches Fachgebiet. |
| 1957/1958 | Perzeptron | Frank Rosenblatt entwickelt ein frühes lernfähiges Modell zur Mustererkennung. |
| 1956–1959 | Logic Theorist und General Problem Solver | Programme bearbeiten logische Beweise und formal beschriebene Probleme. |
| 1966 | ELIZA | Der Chatbot simuliert ein Gespräch mit einem Psychotherapeuten. |
| ab 1972 | MYCIN | Das medizinische Expertensystem leitet Empfehlungen aus festgelegten Regeln ab. |
| 1970er-Jahre | Erster KI-Winter | Enttäuschte Erwartungen führen zu gekürzten Forschungsgeldern. |
| 1980er-Jahre | Boom der Expertensysteme | Unternehmen setzen regelbasierte KI erstmals in größerem Umfang ein. |
| 1986 | Backpropagation und NETtalk | Mehrschichtige neuronale Netze lassen sich wirksamer trainieren. |
| späte 1980er-/frühe 1990er-Jahre | Zweiter KI-Winter | Hohe Kosten und begrenzte Praxiserfolge bremsen den Markt erneut. |
| 1997 | Deep Blue | Ein Computer besiegt erstmals einen amtierenden Schachweltmeister in einem Wettkampf. |
| 2011 | Watson und Siri | Sprachverarbeitung und Frage-Antwort-Systeme erreichen ein breites Publikum. |
| 2012 | AlexNet | Deep Learning erzielt einen deutlichen Leistungssprung bei der Bilderkennung. |
| 2016 | AlphaGo | Ein KI-System schlägt einen der weltweit besten Go-Spieler. |
| 2017 | Transformer-Architektur | Die Architektur wird zur Grundlage vieler moderner Sprach- und multimodaler Modelle. |
| 2022 | ChatGPT | Generative KI erreicht innerhalb kurzer Zeit den Massenmarkt. |
| ab 2024 | Multimodale und agentische KI | Modelle verarbeiten Text, Bilder, Sprache und Video und führen mehrstufige Aufgaben aus. |
Die theoretischen Grundlagen: Alan Turing und die Frage nach denkenden Maschinen
Die moderne Geschichte der Künstlichen Intelligenz beginnt nicht mit einem Roboter oder einem Chatbot, sondern mit Mathematik. Der britische Mathematiker Alan Turing beschrieb 1936 eine abstrakte Rechenmaschine, die heute als Turingmaschine bekannt ist. Sie kann einen Algorithmus Schritt für Schritt ausführen, sofern sich die jeweilige Aufgabe formal beschreiben lässt.
Die Turingmaschine war selbst noch keine KI. Sie zeigte jedoch, dass sich Rechenvorgänge, logische Regeln und symbolische Operationen in einer universellen Maschine abbilden lassen. Damit entstand eine theoretische Grundlage für programmierbare Computer.
1950 ging Turing einen Schritt weiter. In seinem Aufsatz „Computing Machinery and Intelligence“ stellte er die berühmte Frage: Können Maschinen denken? Weil sich „Denken“ kaum eindeutig messen lässt, schlug er das sogenannte Imitationsspiel vor, das später als Turing-Test bekannt wurde.
Dabei kommuniziert eine prüfende Person schriftlich mit einem Menschen und einer Maschine, ohne zu wissen, wer sich hinter welchem Gesprächspartner verbirgt. Kann sie die Maschine nicht zuverlässig erkennen, hat diese zumindest ein überzeugend menschliches Kommunikationsverhalten gezeigt.
Der Test misst allerdings weder Bewusstsein noch Gefühle oder ein echtes Weltverständnis. Er prüft vor allem, wie glaubwürdig eine Maschine in einem Gespräch wirkt. Diese Unterscheidung ist heute wichtiger denn je. Moderne Sprachmodelle können überzeugende Antworten formulieren, ohne den Inhalt im menschlichen Sinn zu erleben oder zu verstehen. Mehr zu dieser offenen Frage erklärt unser Beitrag über ein mögliches Bewusstsein künstlicher Intelligenz.
1943: Das erste mathematische Modell eines künstlichen Neurons
Noch vor dem Dartmouth-Treffen legten Warren McCulloch und Walter Pitts eine wichtige Grundlage für neuronale Netze. 1943 beschrieben sie Nervenzellen als vereinfachte mathematische Schaltelemente. Ein solches künstliches Neuron verarbeitet Eingangssignale und gibt ein Signal weiter, sobald ein festgelegter Schwellenwert erreicht ist.
Das Modell war stark vereinfacht. Es bildete weder die biologische Komplexität des Gehirns noch Lernprozesse vollständig ab. Trotzdem zeigte es, dass sich bestimmte logische Funktionen mit miteinander verbundenen künstlichen Nervenzellen darstellen lassen.
Damit entstanden zwei Forschungsrichtungen, die die KI-Geschichte über Jahrzehnte prägen sollten:
- Symbolische KI: Wissen, Regeln und logische Beziehungen werden ausdrücklich programmiert.
- Subsymbolische KI: Ein System lernt Muster über künstliche neuronale Netze aus Beispieldaten.
Die heutige KI kombiniert diese Ansätze teilweise miteinander. Sprachmodelle, Bilderkennung und viele industrielle Systeme beruhen vor allem auf maschinellem Lernen. Regelwerke, Wissensdatenbanken und logische Prüfverfahren spielen dennoch weiterhin eine wichtige Rolle.
1955 oder 1956: Wann wurde der Begriff Künstliche Intelligenz erfunden?
In vielen Darstellungen steht, John McCarthy habe den Begriff „Artificial Intelligence“ 1956 auf der Dartmouth Conference erfunden. Das ist verkürzt.
Der Ausdruck erschien bereits 1955 im Antrag für das geplante „Dartmouth Summer Research Project on Artificial Intelligence“. Verfasst wurde der Antrag von John McCarthy, Marvin Minsky, Nathaniel Rochester und Claude Shannon. Das eigentliche Treffen fand im Sommer 1956 statt.
Damit gelten zwei Jahreszahlen:
- 1955 steht für die nachweisbare Verwendung des Begriffs im Projektantrag.
- 1956 steht für die formelle Etablierung von KI als eigenständiges Forschungsfeld.
Die Teilnehmer gingen von einer ausgesprochen optimistischen Annahme aus: Lernen und andere Bestandteile menschlicher Intelligenz müssten sich so exakt beschreiben lassen, dass eine Maschine sie simulieren könne. Wie schwierig das tatsächlich werden würde, unterschätzten viele Beteiligte.
Rechenleistung war teuer, Speicherplatz knapp und geeignete Datenbestände existierten kaum. Noch schwerer wog ein grundsätzliches Problem: Menschliches Wissen besteht nicht nur aus sauber formulierten Regeln. Alltagserfahrung, Kontext, Mehrdeutigkeit und unausgesprochene Annahmen lassen sich nur schwer in Programmcode übersetzen.
Frühe KI-Programme: Logic Theorist, ELIZA und MYCIN
Logic Theorist löste mathematische Beweise
Zu den ersten bedeutenden KI-Programmen gehörte der Logic Theorist von Allen Newell, Herbert A. Simon und Cliff Shaw. Das Programm konnte mathematische Sätze durch logische Schlussfolgerungen beweisen. Beim Dartmouth-Treffen wurde es als Beispiel dafür präsentiert, dass Computer nicht nur Zahlen berechnen, sondern auch symbolische Probleme bearbeiten können.
Der Logic Theorist war kein allgemein intelligentes System. Er arbeitete in einem klar abgegrenzten Aufgabenraum. Genau dieses Prinzip prägt KI bis heute: Ein System kann bei einer bestimmten Aufgabe außergewöhnlich leistungsfähig sein und bei einer scheinbar einfachen Alltagsfrage trotzdem scheitern.
ELIZA wirkte verständnisvoll, verstand aber nichts
1966 veröffentlichte der deutsch-amerikanische Informatiker Joseph Weizenbaum das Programm ELIZA. Eine bekannte Variante ahmte einen Psychotherapeuten nach. ELIZA erkannte Schlüsselwörter, wandelte Aussagen in Rückfragen um und griff auf vorbereitete Textmuster zurück.
Technisch war das System überschaubar. Auf Menschen wirkte es dennoch überraschend überzeugend. Einige Nutzer schrieben dem Programm Verständnis, Einfühlungsvermögen oder sogar eine Persönlichkeit zu.
Weizenbaum zeigte damit unbeabsichtigt ein Phänomen, das später als ELIZA-Effekt bekannt wurde: Menschen neigen dazu, sprachlich überzeugenden Computersystemen mehr Verständnis zuzuschreiben, als tatsächlich vorhanden ist. Das gilt auch für moderne Chatbots. Flüssige Sprache ist kein Beweis für Bewusstsein, Wahrheitsgehalt oder verlässliches Schlussfolgern.
MYCIN brachte Fachwissen in Regeln
In den frühen 1970er-Jahren entstand an der Stanford University das medizinische Expertensystem MYCIN. Es sollte Ärzte bei der Einordnung bestimmter bakterieller Infektionen und bei der Wahl geeigneter Antibiotika unterstützen.
Das Wissen wurde in zahlreichen Wenn-dann-Regeln gespeichert. MYCIN konnte daraus Empfehlungen ableiten und Unsicherheiten gewichten. Die Software zeigte eindrucksvoll, dass regelbasierte Systeme in eng begrenzten Fachgebieten nützliche Ergebnisse liefern können.
Im klinischen Alltag setzte sich MYCIN dennoch nicht breit durch. Neben technischen Grenzen spielten Haftungsfragen, fehlende Integration in Arbeitsabläufe und die Akzeptanz bei Anwendern eine Rolle. Dieses Beispiel liefert eine bis heute gültige Lektion: Eine KI ist nicht automatisch praxistauglich, nur weil sie in einem Test gute Ergebnisse erzielt.
Expertensysteme: Der erste kommerzielle KI-Boom
In den 1980er-Jahren wurden Expertensysteme zum großen Hoffnungsträger. Unternehmen versuchten, das Wissen erfahrener Fachkräfte in umfangreichen Regelwerken abzubilden. Eingesetzt wurden solche Systeme unter anderem bei Fehlerdiagnosen, Konfigurationen, Wartungsentscheidungen und Produktionsabläufen.
Die Technik funktionierte gut, solange die Regeln eindeutig und der Aufgabenbereich überschaubar waren. In dynamischen Situationen stieß sie schnell an Grenzen. Jede neue Ausnahme musste von Fachleuten erkannt, beschrieben und von sogenannten Knowledge Engineers in das System eingepflegt werden.
Mit wachsendem Regelbestand wurde die Wartung kompliziert. Regeln konnten sich widersprechen, seltene Sonderfälle wurden übersehen und Veränderungen in der realen Welt machten ständige Aktualisierungen nötig.
Trotz dieser Probleme markierten Expertensysteme einen Wendepunkt. KI verließ die Universitäten und hielt Einzug in Unternehmen. Das Deutsche Museum ordnet Expertensysteme als einen der Bereiche ein, die sich in der westdeutschen KI-Forschung der 1980er-Jahre deutlich herausbildeten.
Warum gab es sogenannte KI-Winter?
Die Entwicklung der Künstlichen Intelligenz verlief nie gleichmäßig. Auf große Versprechen folgten mehrfach Phasen der Ernüchterung. Diese Zeiträume werden als KI-Winter bezeichnet.
Der erste KI-Winter begann in den 1970er-Jahren. Viele angekündigte Fortschritte blieben aus. Frühe Systeme funktionierten nur in stark vereinfachten Umgebungen. Computer waren zu langsam, Speicher war teuer und die Programme konnten kaum mit mehrdeutigen Alltagssituationen umgehen.
Ein zweiter Einbruch folgte gegen Ende der 1980er- und zu Beginn der 1990er-Jahre. Expertensysteme erwiesen sich als wartungsintensiv. Spezielle KI-Computer verloren gegenüber preiswerteren Standardrechnern an Bedeutung. Unternehmen strichen Projekte, Investoren wurden vorsichtiger und öffentliche Förderprogramme liefen aus.
Zu den typischen Ursachen der KI-Winter gehörten:
- überzogene Versprechen und unrealistische Zeitpläne,
- zu geringe Rechenleistung,
- fehlende oder ungeeignete Trainingsdaten,
- hohe Entwicklungs- und Wartungskosten,
- schlechte Übertragbarkeit auf neue Situationen,
- große Unterschiede zwischen Laborversuchen und praktischer Anwendung.
Die Forschung verschwand während dieser Phasen nicht. Sie lief unter Begriffen wie Mustererkennung, Statistik, maschinelles Lernen, Computer Vision oder Wissensverarbeitung weiter. Viele Grundlagen späterer Durchbrüche entstanden genau in den Jahren, die rückblickend als KI-Winter bezeichnet werden.
Neuronale Netze und maschinelles Lernen verändern die Richtung
Regelbasierte KI erhält ihr Wissen hauptsächlich durch Menschen. Maschinelles Lernen verfolgt einen anderen Ansatz: Das System erkennt statistische Zusammenhänge in Daten und verbessert seine Ergebnisse anhand von Beispielen.
Nach der Definition der Fraunhofer-Gesellschaft ist maschinelles Lernen ein Teilgebiet der KI, bei dem Methoden Wissen aus Daten extrahieren und darin enthaltene Zusammenhänge selbstständig lernen. Deep Learning wiederum nutzt künstliche neuronale Netze mit zahlreichen hintereinanderliegenden Ebenen.
Ein frühes Lernmodell war das von Frank Rosenblatt entwickelte Perzeptron. Es konnte Eingaben gewichten und einfache Musterklassen unterscheiden. Die Fähigkeiten blieben begrenzt, doch das Grundprinzip lebt in modernen neuronalen Netzen weiter.
In den 1980er-Jahren wurde das Training mehrschichtiger Netze durch die breitere Nutzung des Backpropagation-Verfahrens deutlich praktikabler. Fehler werden dabei vom Ausgang des Netzes rückwärts durch die einzelnen Schichten verteilt. Die Gewichte lassen sich anschließend so anpassen, dass das Modell bei vergleichbaren Aufgaben bessere Ergebnisse liefert.
NETtalk von Terrence Sejnowski und Charles Rosenberg demonstrierte 1986, wie ein neuronales Netz die Aussprache englischer Wörter aus Beispielen lernen konnte. Die Sprachausgabe war anfangs holprig, verbesserte sich aber während des Trainings. Das war ein klarer Unterschied zu starr programmierten Regelsystemen.
1997: Deep Blue besiegt Garri Kasparow
Im Mai 1997 besiegte der IBM-Computer Deep Blue den amtierenden Schachweltmeister Garri Kasparow in einem Wettkampf über sechs Partien. Das Ereignis wurde weltweit als Triumph der Maschine über den Menschen wahrgenommen.
Deep Blue arbeitete allerdings anders als heutige generative KI. Das System berechnete sehr viele mögliche Zugfolgen, bewertete die entstehenden Positionen und nutzte von Menschen entwickelte Schachregeln sowie umfangreiche Eröffnungsdaten.
Der Computer war im Schach extrem leistungsfähig, konnte aber weder ein Gespräch führen noch Gegenstände erkennen oder sein Wissen flexibel auf andere Aufgaben übertragen. Deep Blue ist deshalb ein Paradebeispiel für sogenannte schwache oder spezialisierte KI.
Der Sieg zeigte trotzdem, dass Maschinen Menschen in klar definierten, rechenintensiven Aufgaben übertreffen können. Ähnliche Entwicklungen folgten später bei Bilderkennung, Spracherkennung, Übersetzung, Proteinstrukturen und dem Brettspiel Go.
2012: AlexNet macht Deep Learning zum Durchbruch
Neuronale Netze existierten bereits seit Jahrzehnten. Warum setzte sich Deep Learning dann erst ab den 2010er-Jahren so deutlich durch? Drei Entwicklungen kamen zusammen:
- leistungsfähige Grafikprozessoren konnten viele Berechnungen parallel ausführen,
- durch das Internet standen erheblich größere Datenmengen zur Verfügung,
- verbesserte Trainingsverfahren ermöglichten tiefere und stabilere Netze.
Ein viel beachteter Wendepunkt war der Bilderkennungswettbewerb ImageNet im Jahr 2012. Das neuronale Netz AlexNet erzielte einen klaren Vorsprung gegenüber den bis dahin üblichen Verfahren. Es lernte relevante Bildmerkmale weitgehend selbst aus einer großen Menge beschrifteter Bilder.
Damit begann ein neuer KI-Boom. Deep Learning verbesserte innerhalb weniger Jahre die Objekt- und Gesichtserkennung, automatische Übersetzungen, Spracherkennung und medizinische Bildanalyse.
Der Fortschritt hatte allerdings seinen Preis. Tiefe neuronale Netze benötigen oft große Trainingsdatensätze und erhebliche Rechenleistung. Ihre Entscheidungen sind außerdem nicht immer leicht nachvollziehbar. Fraunhofer-Forschende zeigten beispielsweise, dass Bilderkennungssysteme richtige Ergebnisse aus falschen Gründen liefern können – etwa weil sie sich am Bildhintergrund statt am eigentlichen Objekt orientieren.
2017: Transformer werden zur Grundlage moderner Sprachmodelle
Der nächste große Sprung erfolgte 2017 mit der Transformer-Architektur. Sie kann Beziehungen zwischen Wörtern und anderen Datenelementen effizient über größere Abstände hinweg berücksichtigen. Dazu nutzt sie einen Mechanismus, der meist als Attention bezeichnet wird.
Transformer lassen sich parallel trainieren und auf sehr große Datenmengen skalieren. Dadurch wurden Modelle möglich, die Texte zusammenfassen, übersetzen, fortsetzen, klassifizieren oder neu erzeugen können.
Auf dieser Architektur beruhen viele Large Language Models, kurz LLMs. Sie lernen aus sehr großen Textbeständen, welche Wörter oder Textbestandteile in einem bestimmten Zusammenhang wahrscheinlich aufeinanderfolgen.
Das Modell speichert dabei nicht einfach eine klassische Datenbank mit fertigen Antworten. Es bildet statistische Muster in seinen Parametern ab und erzeugt auf dieser Grundlage neue Ausgaben. Das erklärt sowohl die erstaunliche sprachliche Flexibilität als auch eine zentrale Schwäche: Ein Sprachmodell kann eine plausible, aber sachlich falsche Antwort formulieren.
2022: ChatGPT bringt generative KI in den Alltag
Generative Modelle gab es bereits vor ChatGPT. Die Veröffentlichung Ende November 2022 veränderte jedoch die öffentliche Wahrnehmung. Plötzlich konnten Menschen ohne Programmierkenntnisse mit einem leistungsfähigen Sprachmodell kommunizieren.
ChatGPT konnte Texte entwerfen, Fragen beantworten, Programmcode erklären, Inhalte zusammenfassen und Ideen entwickeln. Die Bedienung über ein einfaches Chatfenster senkte die Einstiegshürde drastisch.
Seitdem haben sich generative Systeme schnell weiterentwickelt. Moderne Modelle verarbeiten nicht nur Text, sondern auch Bilder, Audiodaten und Videos. Manche Systeme können Werkzeuge aufrufen, Suchvorgänge durchführen, Dateien analysieren oder längere Arbeitsabläufe in einzelne Schritte zerlegen.
Wer die weitere Entwicklung verfolgen möchte, findet in unserer Übersicht zur aktuellen KI-Entwicklung eine vertiefende Einordnung. Praktische Angebote für visuelle Inhalte stellen wir außerdem in unserem Vergleich der besten KI-Bildgeneratoren vor.
Seit wann wird KI in Deutschland erforscht?
Auch in Deutschland reicht die KI-Forschung mehrere Jahrzehnte zurück. Nach den Untersuchungen des Deutschen Museums etablierte sich die maschinelle Sprachverarbeitung bereits Anfang der 1960er-Jahre im Umfeld der Linguistik.
Ab Mitte der 1970er-Jahre formierte sich eine eigenständige westdeutsche KI-Community. Forschungsbereiche wie automatisches Beweisen, Bildverarbeitung, Sprachverarbeitung, Expertensysteme und Kognitionswissenschaft entwickelten eigene Schwerpunkte.
In den 1980er-Jahren entstanden stärkere institutionelle Strukturen. Universitäten und Forschungszentren beschäftigten sich mit wissensbasierten Systemen, logischer Programmierung, Robotik und maschineller Sprachverarbeitung. 1988 wurde das Deutsche Forschungszentrum für Künstliche Intelligenz gegründet.
Heute liegt eine besondere Stärke Deutschlands bei industrieller KI, Produktion, Maschinenbau, Medizin, Mobilität und Robotik. Wie KI und Robotik in modernen Produktionskonzepten zusammenwachsen, zeigt unser Beitrag zur Industrie 5.0.
Wie verbreitet ist Künstliche Intelligenz heute?
KI ist längst kein reines Forschungsthema mehr. Sie steckt in Empfehlungsalgorithmen, Spamfiltern, Übersetzungsdiensten, Navigationssystemen, Betrugserkennung, industrieller Qualitätskontrolle und Bildbearbeitung.
Aktuelle Erhebungen zeigen allerdings unterschiedliche Nutzungsquoten. Nach Angaben des Statistischen Bundesamtes nutzten 2025 rund 26 Prozent der Unternehmen in Deutschland mit mindestens zehn Beschäftigten KI-Technologien. Eine Bitkom-Erhebung vom Frühjahr 2026 kommt bei Unternehmen ab 20 Beschäftigten auf 41 Prozent.
Die Werte widersprechen sich nicht zwangsläufig. Sie stammen aus unterschiedlichen Jahren, verwenden abweichende Unternehmensgrößen und beruhen auf verschiedenen Erhebungsmethoden. Genau deshalb sollten KI-Statistiken nie ohne Bezugsjahr und Grundgesamtheit zitiert werden.
Die Bitkom-Befragung zeigt außerdem, dass weitere 48 Prozent der befragten Unternehmen den Einsatz von KI planen oder diskutieren. Von den bereits aktiven Unternehmen berichteten 45 Prozent über deutlich beschleunigte interne Prozesse und 44 Prozent über verbesserte Produkte oder Dienstleistungen.
Die wirtschaftliche Verbreitung bringt zugleich neue Regeln mit sich. Unternehmen müssen klären, welche Daten in KI-Systeme eingegeben werden dürfen, wie Ergebnisse geprüft werden und welche Pflichten aus dem europäischen KI-Recht entstehen. Einen aktuellen Überblick bietet unser Leitfaden zum EU AI Act.
Was heutige KI kann – und was nicht
Der Begriff „Künstliche Intelligenz“ klingt nach einer Maschine mit Verstand, Selbstbewusstsein und eigenen Absichten. Die meisten heute eingesetzten Systeme funktionieren deutlich nüchterner.
Aktuelle KI kann unter anderem:
- Muster in großen Datenmengen erkennen,
- Texte, Bilder, Sprache und Videos analysieren,
- Inhalte auf Grundlage gelernter Wahrscheinlichkeiten erzeugen,
- Prognosen und Klassifizierungen erstellen,
- Roboterbewegungen und industrielle Prozesse unterstützen,
- fest umrissene Aufgaben teilweise besser als Menschen lösen.
Sie besitzt dadurch aber nicht automatisch menschliches Verständnis. Ein Sprachmodell kann eine überzeugende Erklärung formulieren und trotzdem eine Quelle erfinden, Zahlen verwechseln oder einen falschen Zusammenhang herstellen.
Das Bundesamt für Sicherheit in der Informationstechnik bezeichnet solche frei erfundenen, zugleich glaubhaft wirkenden Ausgaben als Halluzinationen. Besonders kritisch sind sie in Medizin, Recht, Finanzen, Technik und anderen Bereichen, in denen falsche Angaben reale Schäden verursachen können.
Auch Verzerrungen in Trainingsdaten können sich in den Ergebnissen widerspiegeln. Hinzu kommen Risiken durch manipulierte Eingaben, vertrauliche Daten, mangelnde Transparenz und eine unkritische Übernahme automatisch erzeugter Inhalte.
Praxisregel: KI-Ausgaben sind Entwürfe oder Entscheidungshilfen, keine automatische Wahrheitsquelle. Zahlen, Namen, Zitate, Rechtsauskünfte, medizinische Aussagen und Quellen sollten immer unabhängig geprüft werden.
Was kommt nach generativer KI?
Die nächste Entwicklungsphase verbindet Sprachmodelle zunehmend mit Werkzeugen, Sensoren und physischen Maschinen. Statt lediglich einen Text zu erzeugen, sollen Systeme Aufgaben planen, Zwischenergebnisse prüfen und externe Anwendungen bedienen.
Bei sogenannter agentischer KI erhält ein Modell ein Ziel und zerlegt es in mehrere Arbeitsschritte. Dazu kann es etwa Datenbanken durchsuchen, Dokumente auswerten oder Softwarefunktionen aufrufen. Vollständig autonom und zuverlässig sind solche Systeme noch nicht. Je länger ein Ablauf wird, desto mehr können sich kleine Fehler aufsummieren.
In der Robotik entsteht parallel die sogenannte Physical AI. Roboter sollen Sprache, Kamerabilder und Sensordaten gemeinsam verarbeiten, um in realen Umgebungen flexibler zu handeln. Einen technischen Einblick liefert unser Beitrag über den Aufbau humanoider Roboter.
Damit schließt sich ein historischer Kreis. Schon die Forscher des Dartmouth-Projekts wollten Maschinen entwickeln, die lernen, Sprache verwenden und Probleme lösen. Die heutigen Systeme kommen dieser Vision in einzelnen Bereichen erstaunlich nahe. Eine allgemeine, menschenähnliche Intelligenz besitzen sie damit noch nicht.
Fazit: KI gibt es offiziell seit 1956 – ihre Geschichte begann früher
Die klare Antwort lautet: Künstliche Intelligenz gibt es als eigenständiges Forschungsgebiet seit 1956. Der Begriff „Artificial Intelligence“ wurde bereits 1955 im Antrag für das Dartmouth-Forschungsprojekt verwendet. Die theoretischen Grundlagen reichen mit Alan Turings Rechenmodell und den ersten mathematischen Neuronen noch weiter zurück.
Die heutige KI entstand nicht durch einen einzelnen Geistesblitz. Sie ist das Ergebnis aus Mathematik, Informatik, Statistik, Sprachwissenschaft, Neurowissenschaften, wachsender Rechenleistung und riesigen Datenbeständen.
Auch die Entwicklung verlief keineswegs geradlinig. Auf frühe Euphorie folgten KI-Winter. Expertensysteme wurden von maschinellem Lernen ergänzt, neuronale Netze erlebten nach Jahrzehnten ihren Durchbruch und Transformer machten leistungsfähige Sprachmodelle möglich.
ChatGPT war deshalb nicht die Geburt der Künstlichen Intelligenz. Es war der Moment, in dem jahrzehntelange Forschung für einen großen Teil der Bevölkerung direkt sichtbar und nutzbar wurde.
Häufige Fragen zur Geschichte der Künstlichen Intelligenz
Seit wann gibt es Künstliche Intelligenz?
Als eigenständiges wissenschaftliches Forschungsgebiet gibt es Künstliche Intelligenz seit dem Dartmouth-Treffen im Jahr 1956. Wichtige mathematische und technische Grundlagen entstanden jedoch bereits in den 1930er- und 1940er-Jahren.
Wann wurde der Begriff Künstliche Intelligenz erstmals verwendet?
Der Begriff „Artificial Intelligence“ erschien 1955 im Antrag für das Dartmouth Summer Research Project on Artificial Intelligence. Das dazugehörige Forschungstreffen fand im Sommer 1956 statt.
Wer hat die Künstliche Intelligenz erfunden?
Es gibt keinen einzelnen Erfinder der KI. John McCarthy prägte den Begriff, während Alan Turing, Marvin Minsky, Claude Shannon, Herbert Simon, Allen Newell und zahlreiche weitere Forschende wichtige Grundlagen schufen.
Gab es vor 1956 bereits KI?
Vor 1956 existierten bereits theoretische Rechenmodelle, künstliche Neuronen und erste Programme für logische Aufgaben. KI war zu diesem Zeitpunkt jedoch noch nicht als eigenständige wissenschaftliche Disziplin etabliert.
Warum kam es zu den KI-Wintern?
Die Erwartungen an frühe KI-Systeme waren oft höher als ihre tatsächlichen Fähigkeiten. Begrenzte Rechenleistung, fehlende Daten, hohe Kosten und geringe Praxistauglichkeit führten dazu, dass Investitionen und Forschungsgelder gekürzt wurden.
Seit wann gibt es neuronale Netze?
Ein erstes mathematisches Modell künstlicher Nervenzellen veröffentlichten McCulloch und Pitts 1943. Das Perzeptron von Frank Rosenblatt folgte in den 1950er-Jahren. Den breiten Durchbruch erreichten tiefe neuronale Netze ab 2012.
Seit wann gibt es ChatGPT?
ChatGPT wurde Ende November 2022 öffentlich veröffentlicht. Die zugrunde liegende Transformer-Technik existiert seit 2017, während frühere GPT-Modelle bereits vor ChatGPT entwickelt wurden.
Was ist der Unterschied zwischen KI, Machine Learning und Deep Learning?
Künstliche Intelligenz ist der Oberbegriff. Maschinelles Lernen ist ein Teilgebiet, bei dem Systeme Muster aus Daten lernen. Deep Learning ist wiederum eine Form des maschinellen Lernens mit tiefen, mehrschichtigen neuronalen Netzen.
Ist ChatGPT eine echte Künstliche Intelligenz?
ChatGPT ist ein KI-System und gehört zur generativen KI. Es verarbeitet Sprache auf Grundlage gelernter statistischer Muster, besitzt nach heutigem Kenntnisstand aber kein menschliches Bewusstsein oder gesichertes Verständnis.
Kann eine KI denken oder ein Bewusstsein entwickeln?
Heutige KI-Systeme können komplexe Aufgaben bearbeiten und menschlich wirkende Sprache erzeugen. Es gibt jedoch keinen wissenschaftlichen Nachweis, dass aktuelle Modelle ein subjektives Bewusstsein, Gefühle oder menschliches Denken besitzen.
Quellen und weiterführende Informationen
- Deutsches Museum: Geschichte der Künstlichen Intelligenz in der Bundesrepublik Deutschland
- Deutsches Museum Studies: Geschichten der Künstlichen Intelligenz
- Fraunhofer-Gesellschaft: Machine Learning, Deep Learning und neuronale Netze
- Fraunhofer-Allianz Big Data und Künstliche Intelligenz: Generative KI und Transformer
- Bundesamt für Sicherheit in der Informationstechnik: Chancen und Risiken generativer KI-Modelle
- Statistisches Bundesamt: Nutzung von KI-Technologien in deutschen Unternehmen 2025
- Bitkom: Verbreitung von KI in deutschen Unternehmen 2026
Autor Nico Nuss beschäftigt sich seit 2001 mit Mobile Computing und Automatisierungssoftware. Seine langjährige Erfahrung und sein ausgeprägtes Interesse an Zukunftstechnologien bilden die Grundlage seiner Arbeit zu Robotik und künstlicher Intelligenz.