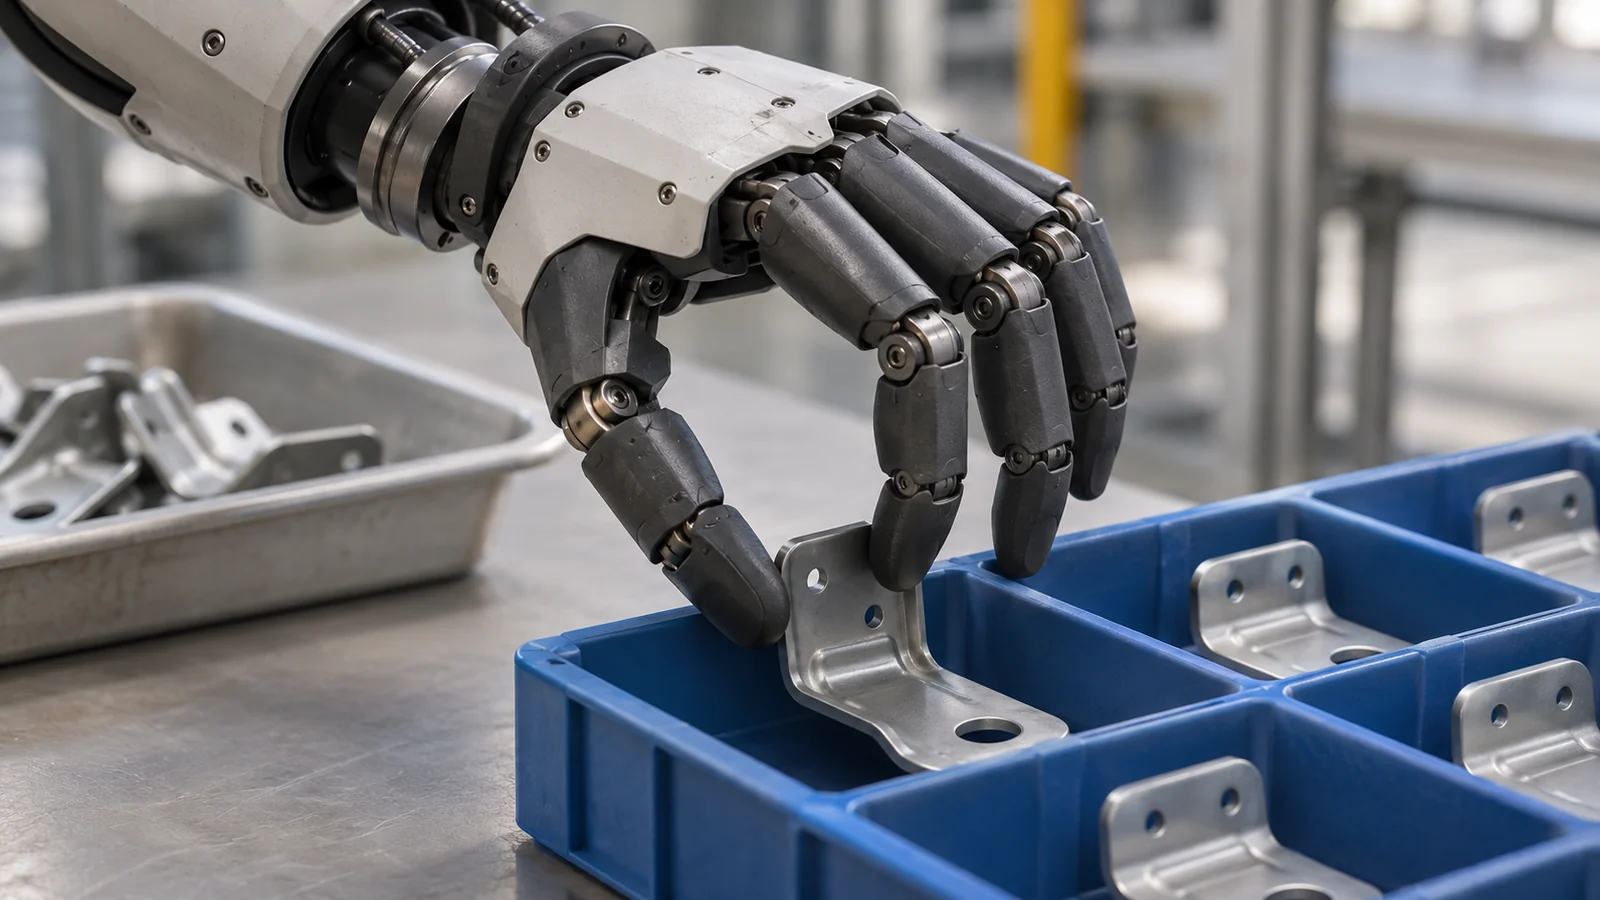
Ilustración generada con IA de clasificación robotizada. No es una fotografía del piloto Mercedes ni una representación exacta de Apollo 2.
Google DeepMind presentó Gemini Robotics 2.5 el 10 de noviembre de 2026 y describió una prueba industrial concreta: el humanoide Apollo 2 de Apptronik clasifica componentes en plantas de Mercedes-Benz. Google comunica un 96% de éxito en la prueba de concepto. Es un resultado piloto declarado por el proveedor, no producción continua verificada de forma independiente.
In this article
Del contenedor a la secuencia correcta
Según Google, la prueba se desarrolla en líneas de producción activas de Kecskemét y Sindelfingen. Apollo 2 recoge soportes metálicos de un contenedor y los coloca en recipientes de secuenciación según el orden de los vehículos, con manos Sharpa Wave de cinco dedos. Gemini Robotics 2.5 controla el movimiento y un modelo Robotics ER ayuda a seguir el flujo de trabajo.
Un modelo de visión, lenguaje y acción relaciona información visual e instrucciones con movimientos. La cuestión práctica no es si el robot parece humano: debe identificar la pieza correcta, elegir un agarre viable y depositarla en su lugar.
Lo que el 96% no permite concluir
La cifra es una señal útil, pero todavía no fundamenta una evaluación económica. El anuncio no ofrece un número de ensayos suficientemente detallado ni un balance completo de tiempos de ciclo, reintentos, intervenciones humanas y disponibilidad. La cobertura del mismo anuncio no constituye una validación independiente.
Nuestro análisis empieza por la definición de éxito. ¿Un primer agarre fallido cuenta como éxito tras repetirlo? ¿Detecta el sistema una pieza mal colocada? ¿Debe alguien recolocar el contenedor? Estas diferencias modifican las necesidades de personal aunque el porcentaje final sea el mismo.
En términos puramente aritméticos, un 96% equivale a cuatro operaciones fallidas por cada 100 intentos definidos de igual manera. No es el tamaño real de la muestra. Un error detectado y corregido por el robot tiene consecuencias distintas a un fallo de secuenciación inadvertido.
Comparar la tarea, no la silueta
Para la industria europea importa el entorno de una línea activa, próximo al flujo real de materiales. Pero ese entorno no demuestra por sí solo un turno completo de funcionamiento ni rentabilidad. También deben medirse interrupciones, retrabajo e integración.
La alternativa relevante puede ser una pinza especializada o un cobot. Una mano versátil aportaría valor si manejara piezas cambiantes con menos reajustes. Para una tarea fija podría bastar una solución sencilla. La comparación justa sería el coste por pieza correctamente preparada en condiciones equivalentes.
Este piloto va más allá de las anteriores pruebas en la nube del planificador robótico de Google. Robotics 2.5 se distribuye inicialmente a socios de robótica; eso no implica disponibilidad general para las fábricas.
La siguiente prueba decisiva sería un ensayo prolongado y bien delimitado: ¿cuántas piezas correctas por hora entrega, incluidas las correcciones, y cuánta ayuda humana necesita?
Fuentes
- Google DeepMind: Gemini Robotics 2.5 — 2026-11-10
- The Decoder: Mercedes-Benz-Pilot — 2026-11-10