Mecka AI soll laut einem Medienbericht vor einer Finanzierung zu einer Bewertung von rund 500 Millionen US-Dollar stehen. Die Zahl ist nicht bestätigt – doch sie lenkt den Blick auf einen knappen Rohstoff der Robotik: hochwertige Daten darüber, wie Menschen in der physischen Welt handeln.
TechCrunch berichtet unter Berufung auf zwei mit den Gesprächen vertraute Quellen, dass Sequoia eine neue Runde bei Mecka AI anführen könnte. Die Bedingungen seien noch nicht endgültig, das Volumen der Runde sei unbekannt. Mecka habe sich nicht geäußert, Sequoia einen Kommentar abgelehnt. Damit ist die genannte Bewertung vorerst eine berichtete Verhandlungsgröße, keine abgeschlossene oder vom Unternehmen bestätigte Transaktion.
Trotz dieser Unsicherheit trifft die Meldung einen Kern des aktuellen Robotikbooms. Sprachmodelle konnten auf riesigen Mengen öffentlich zugänglicher Texte trainiert werden. Für Roboter gibt es kein vergleichbares Archiv korrekt ausgeführter Handbewegungen, Kontaktkräfte, Blickrichtungen und räumlicher Entscheidungen. Jede Tür, jede Verpackung und jedes Werkzeug stellt andere physische Anforderungen. Wer diese Interaktionen in nutzbare Trainingsdaten verwandeln kann, verkauft nicht nur Datenmenge, sondern eine mögliche Abkürzung zu vielseitigeren Maschinen.
In diesem Artikel
Warum Internetvideo allein nicht genügt
Ein Video zeigt, was ein Mensch sieht. Es verrät jedoch oft nicht präzise, wie stark eine Hand drückt, wo genau ein Kontakt entsteht oder welche Bewegung durch Reibung verhindert wird. Kameraperspektive und Verdeckung erschweren die Rekonstruktion. Zudem besitzt ein Roboter andere Gelenke, Reichweiten und Greifer als ein Mensch. Eine menschliche Bewegung lässt sich deshalb nicht einfach Bild für Bild kopieren.
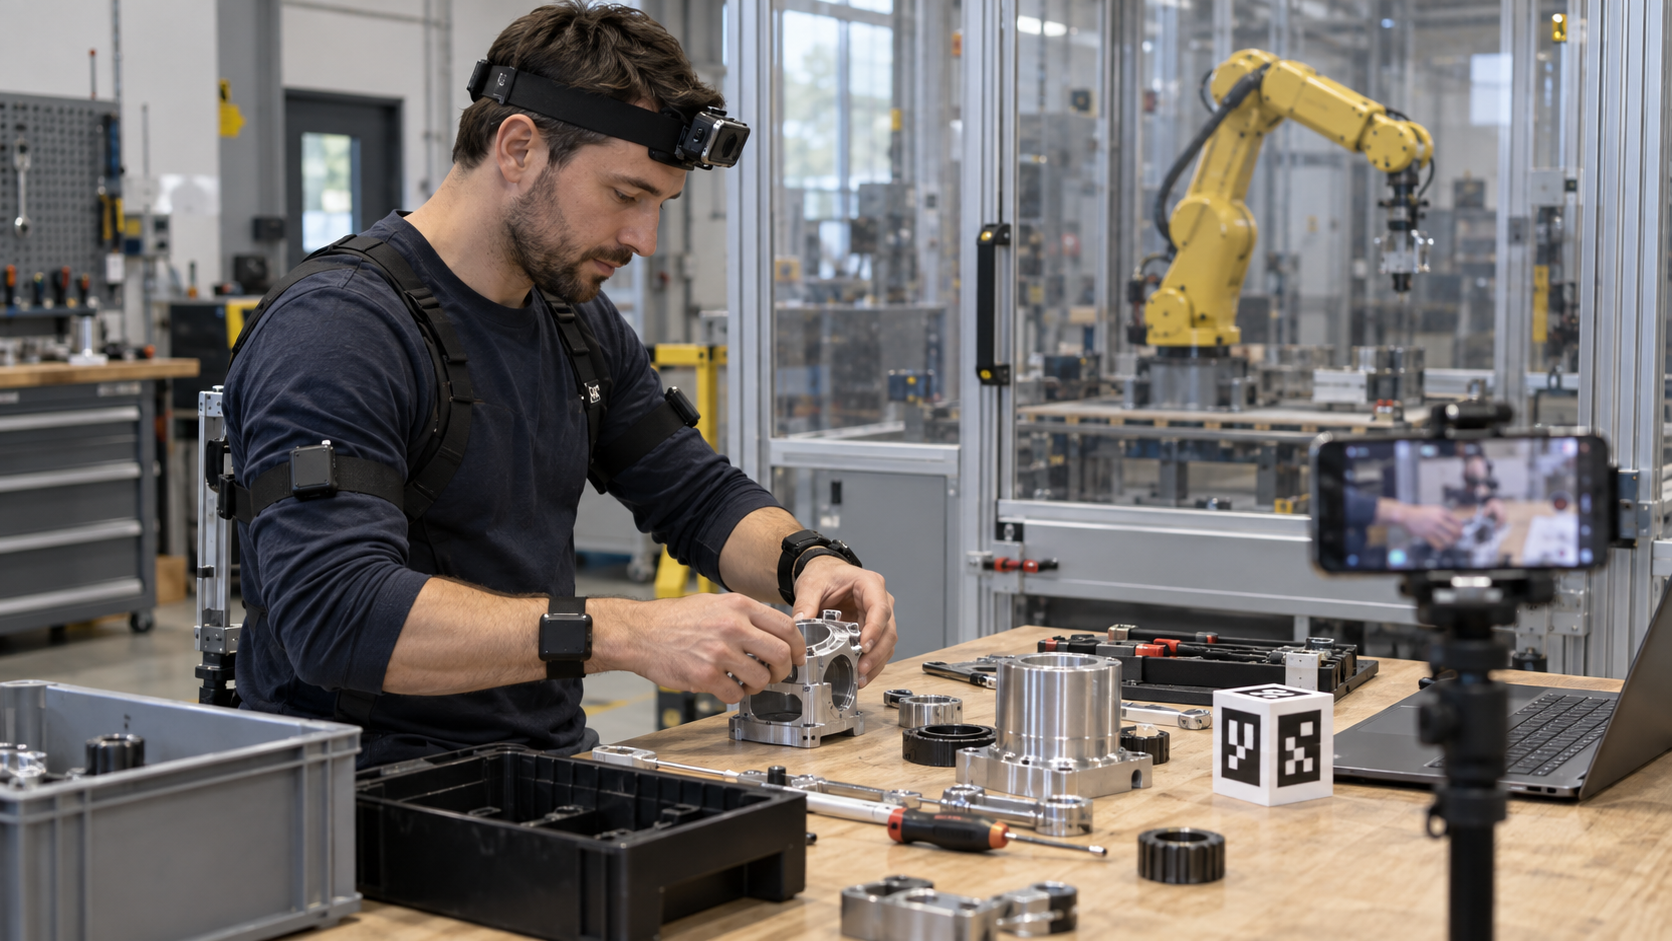
Mecka beschreibt auf seiner Website einen Daten- und Evaluationsstack, der neben Bilddaten unter anderem Tiefe, Objektverfolgung, Segmentierung, Bewegung, Punktwolken, Oberflächen, Lokalisierung, Ton und taktile Kräfte erfassen oder verarbeiten soll. Das ist die richtige Problemdefinition: Rohmaterial wird erst durch Kalibrierung, zeitliche Synchronisierung, Annotation und Qualitätskontrolle zu einem Trainingsdatensatz. Die Angaben stammen vom Anbieter und sagen allein noch nichts darüber aus, wie gut daraus trainierte Roboter bei Kunden funktionieren.
Nach einem Bericht von Fortune hatte Mecka im Juni insgesamt 60 Millionen US-Dollar Finanzierung bekannt gegeben: eine Serie A über 25 Millionen Dollar und eine Folgefinanzierung über 35 Millionen. Das Unternehmen beschäftigte demnach rund 40 Menschen. Kunden wurden nicht namentlich genannt. Auch eine berichtete Prognose von 100 Millionen Dollar jährlicher Umsatzrate aus unterzeichneten Verträgen bleibt ohne offengelegte Vertragsdetails schwer einzuordnen.
Der schwierige Sprung vom Menschen zur Maschine
In der Forschung heißt dieses Problem häufig Embodiment Gap: Wissen entsteht in einem menschlichen Körper, soll aber von einer Maschine mit anderer Gestalt ausgeführt werden. Ein Mensch kann eine Schraube zwischen Daumen und Zeigefinger drehen, den Widerstand fühlen und die Hand spontan neu positionieren. Ein Zwei-Finger-Greifer braucht dafür eine andere Bahn, andere Kräfte und womöglich eine Hilfsvorrichtung. Selbst bei einem humanoiden Roboter stimmen Gelenkwinkel, Nachgiebigkeit und Sichtfeld nicht exakt überein.
Neue Forschungsarbeiten zeigen, wie dieser Abstand verkleinert werden kann. Das Ego2Robot-Projekt beschreibt eine Pipeline, die egozentrische menschliche Videos über Bewegungsübertragung, visuelle Synthese eines Roboterarms und mehrstufige Qualitätskontrolle in Robotikdaten umwandelt. Die Autoren berichten von 18.561 Stunden synthetisierter Daten über 15 Roboterformen. Das ist eine beachtliche Skalierung im Forschungsrahmen, aber keine Garantie dafür, dass jede Stunde denselben Lernwert besitzt.
Auch das EgoVerse-Projekt ist aufschlussreich. Die im April veröffentlichte Arbeit dokumentiert 1.362 Stunden und rund 80.000 Episoden mit 1.965 Aufgaben, 240 Szenen und mehr als 2.000 ausführenden Personen. Die Ergebnisse sprechen grundsätzlich dafür, dass menschliche Daten Robotermodelle verbessern können. Zugleich betonen die Autoren, dass der Nutzen davon abhängt, wie gut Datenquelle und Lernziel zusammenpassen. Die aktuelle Projektseite nennt inzwischen 4.003 Stunden; diese laufend aktualisierte Zahl darf nicht mit dem Stand des Papers verwechselt werden.
Viele Stunden sind noch kein Burggraben
Für Investoren klingt ein wachsendes Datenarchiv zunächst wie ein klassischer Netzwerkeffekt: mehr Aufnahmen ermöglichen bessere Modelle, bessere Modelle ziehen mehr Kunden an und deren Aufgaben erzeugen wiederum neue Daten. Ob daraus wirklich ein dauerhafter Vorteil entsteht, hängt jedoch von der Exklusivität und Qualität ab. Standardisierte Videos einfacher Tischaufgaben können schnell zur austauschbaren Ware werden. Wertvoller sind seltene Fehlerfälle, genaue Kraftdaten, konsistente Metadaten und die Möglichkeit, einen Datensatz gezielt an eine konkrete Roboterplattform anzupassen.
Der Burggraben könnte deshalb weniger in der Gesamtzahl der Stunden liegen als in der gesamten Produktionskette: Rekrutierung geeigneter Demonstratoren, zuverlässige Sensorpakete, Datenschutz, automatische Qualitätsprüfung, Übertragung auf verschiedene Roboter und objektive Evaluation nach dem Training. Wer nur Aufnahmen sammelt, konkurriert mit fallenden Kamerakosten. Wer nachweisen kann, dass eine zusätzliche Datenstunde die Erfolgsquote einer realen Aufgabe messbar erhöht, verkauft ein Ergebnis.
Auch die Nähe zum Einsatzort zählt. Daten aus einer sauberen Wohnung helfen nur begrenzt bei öligen Werkstücken, Handschuhen, reflektierenden Oberflächen oder wechselndem Licht in der Produktion. Umgekehrt muss nicht jede Aufgabe mit maximaler Sensorik erfasst werden. Für grobe Bewegungsabläufe kann Video genügen; bei Steckverbindungen oder flexiblen Materialien werden Kraft, Tastsinn und genaue Zeitstempel wichtiger. Ein gutes Datensystem entscheidet, welche Modalität den zusätzlichen Aufwand rechtfertigt.
Die offenen wirtschaftlichen und sozialen Fragen
Die berichtete Bewertung von rund 500 Millionen Dollar würde hohe Erwartungen einpreisen. Ohne veröffentlichte Kundenliste, überprüfte Umsatzzahlen und Details zur neuen Runde bleibt unklar, wie viel davon auf bestehendem Geschäft und wie viel auf der allgemeinen Nachfrage nach Physical AI beruht. Die Bedingungen könnten sich noch ändern. Für eine nüchterne Bewertung wären wiederkehrende Erlöse, Vertragslaufzeiten, Bruttomarge und die Kosten je brauchbarer Datenstunde wichtiger als eine einzelne Schlagzeile.
Hinzu kommen Rechte an den Aufnahmen. Werden Bewegungen am Arbeitsplatz erfasst, müssen Einwilligung, Zweckbindung, Aufbewahrung und spätere Nutzung klar geregelt sein. Körperbewegungen, Umgebungsvideo und Ton können Beschäftigte, Kunden oder vertrauliche Produktionsabläufe erkennen lassen. Das ist eine allgemeine Herausforderung für Datenanbieter; aus den öffentlich zugänglichen Quellen lässt sich nicht ableiten, wie Mecka jeden konkreten Fall handhabt.
Unternehmen, die solche Daten einkaufen, sollten außerdem die Herkunft dokumentieren können. Ein Trainingsdatensatz ist langfristig nur dann wertvoll, wenn Lizenzrechte, Qualitätsfilter und mögliche Verzerrungen nachvollziehbar sind. Andernfalls drohen nicht nur rechtliche Risiken. Ein Modell kann auch falsche Abkürzungen lernen, wenn bestimmte Hände, Arbeitsplätze oder Objektvarianten überrepräsentiert sind.
Der Alpha-Bionic-Blick: Leistung pro Datenstunde
Die spannendste Kennzahl ist nicht die Zahl der aufgezeichneten Stunden. Sie lautet: Wie viel zuverlässige Roboterleistung entsteht pro zusätzlicher Stunde? Dafür braucht es Tests an unbekannten Objekten, veränderten Positionen und neuen Umgebungen. Gemessen werden sollten Erfolgsquote, benötigte Wiederholungen, Eingriffe durch Menschen, sichere Fehlererkennung und die Übertragbarkeit auf andere Roboterkörper.
Besonders überzeugend wäre ein Vergleich mehrerer Trainingswege. Wie schlägt sich ein Modell mit menschlichen Demonstrationen gegenüber Teleoperation, Simulation oder wenigen robotereigenen Beispielen? Welcher Mix liefert bei gleichen Kosten die höchste Erfolgsquote? Und sinkt der zusätzliche Nutzen irgendwann, weil weitere Daten nur bereits bekannte Bewegungen wiederholen? Solche Ergebnisse würden die wirtschaftliche These besser stützen als ein großes Archiv allein.
Die Mecka-Meldung bleibt vorerst eine unbestätigte Finanzierungsstory. Als Marktsignal ist sie dennoch relevant: Robotikunternehmen und Investoren behandeln physische Interaktionsdaten zunehmend als eigene Infrastrukturkategorie. Ob daraus ein Geschäft in der berichteten Größenordnung wird, entscheidet sich nicht an der Eleganz einer Erfassungsvorführung. Entscheidend ist, ob sauber gewonnene menschliche Erfahrung Roboter außerhalb des Labors messbar zuverlässiger macht.
Quellen
- TechCrunch: Bericht über die mögliche Mecka-Finanzierung, 11. September 2026
- Fortune: Bericht zur bisherigen Finanzierung und Geschäftsentwicklung, 1. Juni 2026
- Mecka AI: Darstellung der Daten- und Evaluationsplattform, abgerufen am 14. September 2026
- EgoVerse: Forschungsarbeit zu menschlichen Daten für Robotik, 8. April 2026
- Ego2Robot: Übertragung egozentrischer Videos auf Robotertraining, 3. August 2026